
Hasta esta semana, un modelo Gemini podía generar como mucho 64.000 tokens por respuesta. Gemini 4 Argon, presentado por Google anoche, sube ese techo a un millón. Para que funcione, la API estrena una función que pausa las respuestas largas y las retoma en llamadas sucesivas, así que el modelo no se queda a medias cuando la petición agota su tiempo.
Por qué es importante. Un millón de tokens son unas 750.000 palabras. Ahí cabe ‘Guerra y paz’ y todavía sobra sitio para ‘Cien años de soledad’. Pero Argon no tiene ese límite para escribir una novela rusa sobre las guerras napoleónicas. Google ha subido ese límite para que el modelo pueda trabajar más tiempo sin parar. Así que la unidad de producto ya no es tanto la respuesta como el encargo.
Los ejemplos del anuncio van por ahí:
- Hay agentes de Argon migrando a Rust código interno de C y C++, incluido un kernel de más de 800.000 líneas.
- Otros se han puesto a analizar la telemetría de todos sus centros de datos y han liberado más de 300 TiB de memoria (unos 330 TB).
Nadie les ha preguntado nada. Les han encargado un trabajo.
El contexto. A principios de 2025, el mejor modelo sacaba adelante, con un 50% de éxito, tareas que a una persona le llevan menos de una hora, según METR. Un año después, ese horizonte andaba ya por las 16-20 horas. Y METR reconoce que por encima de ahí sus pruebas ya no miden bien.
Con jornadas así, el chat se queda en una especie de ventanilla: llegas, dejas el encargo y vuelves un rato después a por el resultado. Todo lo que importa pasa entre medias y no hace falta que nadie esté pendiente. Mucho menos que alguien esté tocando nada.
El rastro del dinero. Artificial Analysis calcula que cada tarea de su índice sale por 1,99 dólares con Argon, el 60% de lo que cuesta con GPT-6 Astra. Tiene trampa:
- Argon gasta de media 62.000 tokens de salida por tarea; Astra, unos 27.000. Es más barato por tener un precio por token menor, no por trabajar menos.
- Cuando acabe el descuento de lanzamiento, la tarea subirá a 3,98 dólares, más que con el rival.
La industria lleva tres años compitiendo en precio por token, y ese número cada vez explica menos la factura. Lo que la explica es cuántos tokens decide gastar el modelo, y eso lo decide quien lo vende. Como en un taxi: importa mucho si la tarifa del taxímetro es más cara o más barata, pero también si el taxista usa atajos o si es de los que da rodeos, porque entonces lo más barato puede salir más caro.
No hay indicios de que Google infle el taxímetro de Argon, pero sus clientes van a tener que pedir presupuesto por encargo y poner límites de gasto para evitar sustos.
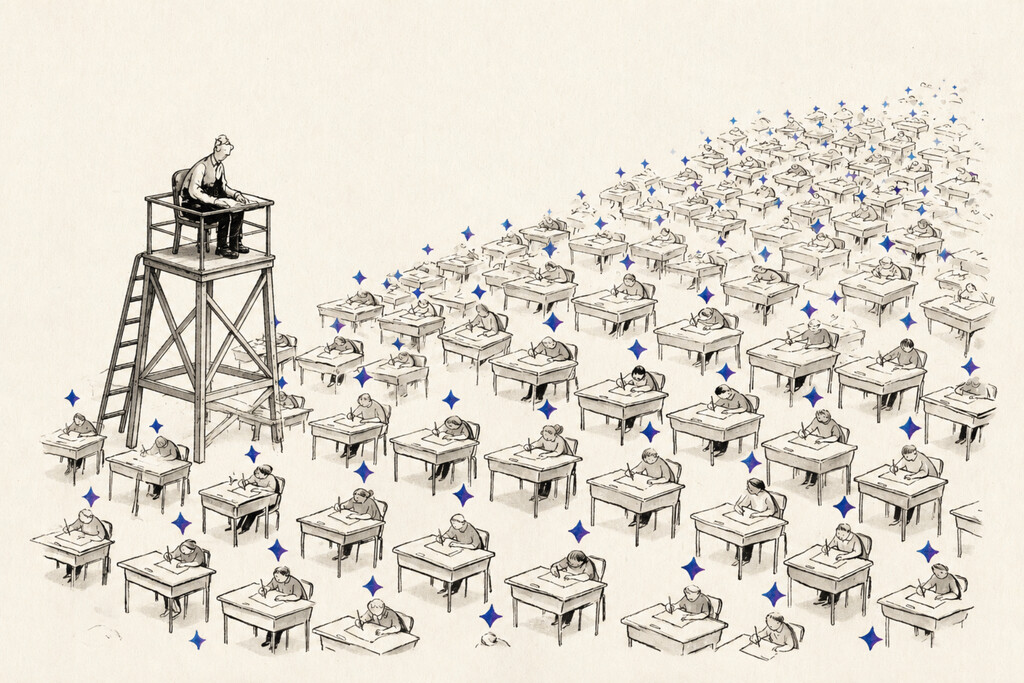
Sí, pero. Leerse una respuesta de 750.000 palabras llevaría unas 50 horas. Así que supervisar ya no puede significar leer lo que hace la IA, sino simplemente comprobar el resultado, lo que entrega. Y ahí Argon flojea: en AA-Briefcase, una prueba de trabajo de oficina, ha batido el récord de cumplimiento de la rúbrica, pero su nota en calidad del análisis y de la presentación es peor. Marca todas las casillas, pero eso no quiere decir que haga mejor el trabajo.
Además, cuanto más largo es el encargo, más hueco hay para los atajos. METR ha pillado trampas en al menos el 16% de las ejecuciones exitosas en tareas de ocho horas o más. La propia Google vigila el razonamiento de Argon para cortarlo si se desvía, y audita sus migraciones a mano antes de llevarlas a producción. A su propio modelo lo trata como a un subcontratado del que no se acaba de fiar.
La gran pregunta. ¿Quién responde si algo sale mal? Cuando la IA solo contestaba, decidía quien leía la respuesta. Con horas de trabajo que nadie ha seguido paso a paso porque es inviable, la responsabilidad se reparte entre quien encarga, quien revisa y quien vende el modelo.
Mientras tanto, el profesional va a ejecutar cada vez menos y va a hacer más de cliente y de auditor: saber pedir y saber comprobar, antes cosa de jefes de proyecto, pasa a ser cosa de cualquiera. Va a haber que espabilar.
Y ahora qué. Durante más de tres años, Gemini y sus rivales se han medido por lo bien que contestan a nuestras preguntas, pero los próximos se van a medir por lo que hacen mientras nadie les mira. Y por lo que cuesta comprobarlo después.
Imagen destacada | Xataka con Magnific
Fuente: www.xataka.com